 AI No Bullshit
- Verdict
- UTILE
- Ça vaut le coup ?
- ÇA DÉPEND
- Preuve
- TESTÉ — AI NO BULLSHIT
Outil testéClaude Custom Skills — Brand QA
Claude Skill : un contrôle de marque réutilisable vaut-il mieux qu’un bon prompt ?
Ce qu'on recommande
Tu répètes souvent la même tâche avec les mêmes règles ? Teste une Skill. C’est ponctuel ? Un bon prompt + ton guide suffit probablement.
Ce qu'on retient
- Une Skill enregistre une méthode, ses règles et son format pour pouvoir la réutiliser.
- Prompt et Skill ont trouvé les mêmes 12 vraies violations ; seule la Skill a évité l’unique fausse alerte.
- Au repeat, un statut sur dix a changé : la Skill n’est pas parfaitement déterministe.
Les limites
- Pour une tâche ponctuelle, le gain face à un bon prompt est trop faible pour justifier forcément une Skill.
- Une Skill ne rend pas Claude parfaitement stable : un statut a changé lors de notre repeat.
- Aucun gain de temps n’a été démontré.
Contraintes
- Coût réel
- 0 € possible · setup/tuning non chronométréDétail dans la fiche complète
- Installation
- Activation vérifiée : Settings → Capabilities → Code execution, puis Customize → Skills → ajouter/activer. Temps de setup total non mesuré de bout en bout pendant ce test ; une friction de packaging SKILL.md/ZIP a dû être corrigée avant les conditions scorées.
- Difficulté
- Facile
- Testé le
- Test pratique
Preuve 01 — ce que ça fait
Baseline complète vs Skill
Même Asset B, mêmes dix règles. La baseline complète marque R8 (géométrie du CTA) en FAIL et compte 4 violations ; la Skill marque R8 en PASS et en compte 3. R1, R6 et R10 sont en FAIL dans les deux tableaux.
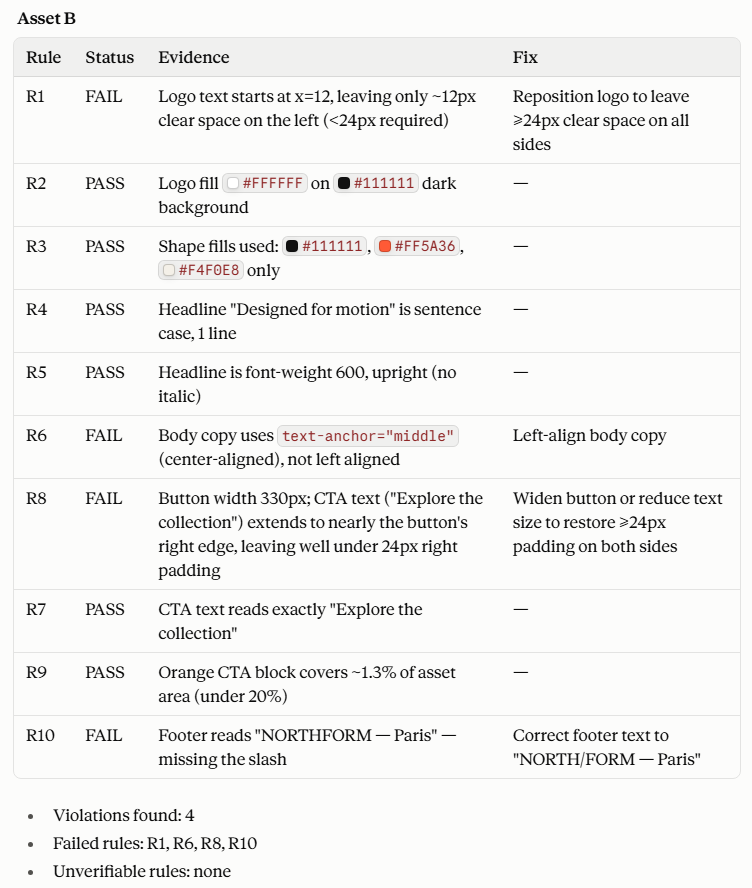 Baseline complète — Asset B
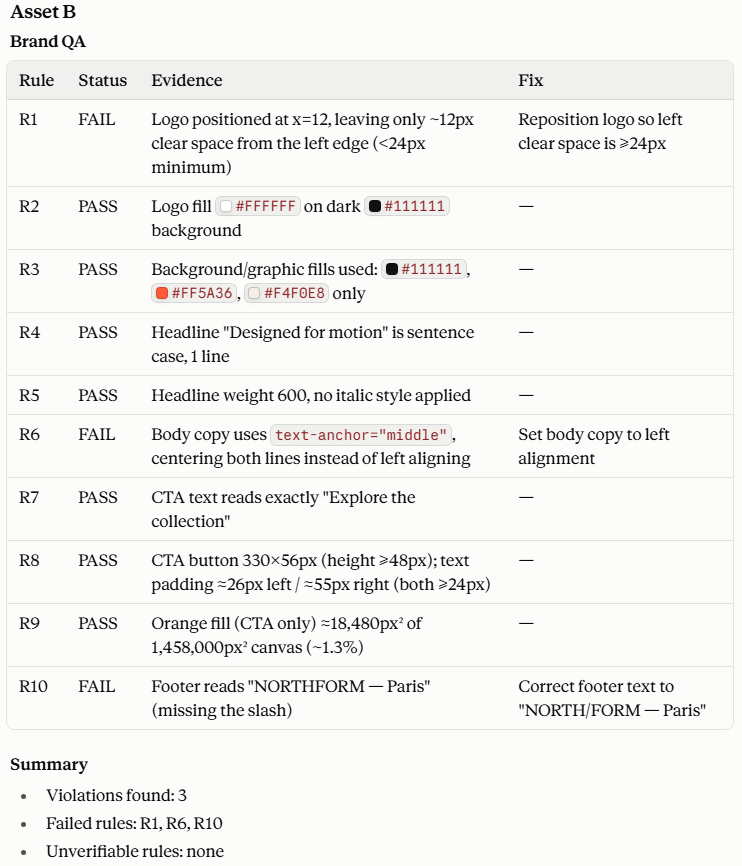 Skill — Asset B
Preuve 02 — là où ça casse
Repeat : pas parfaitement déterministe
Nouveau passage de l'Asset B avec la même Skill : R1, R6 et R10 restent en FAIL, mais R8 passe de PASS à UNVERIFIABLE.
Skill — run principal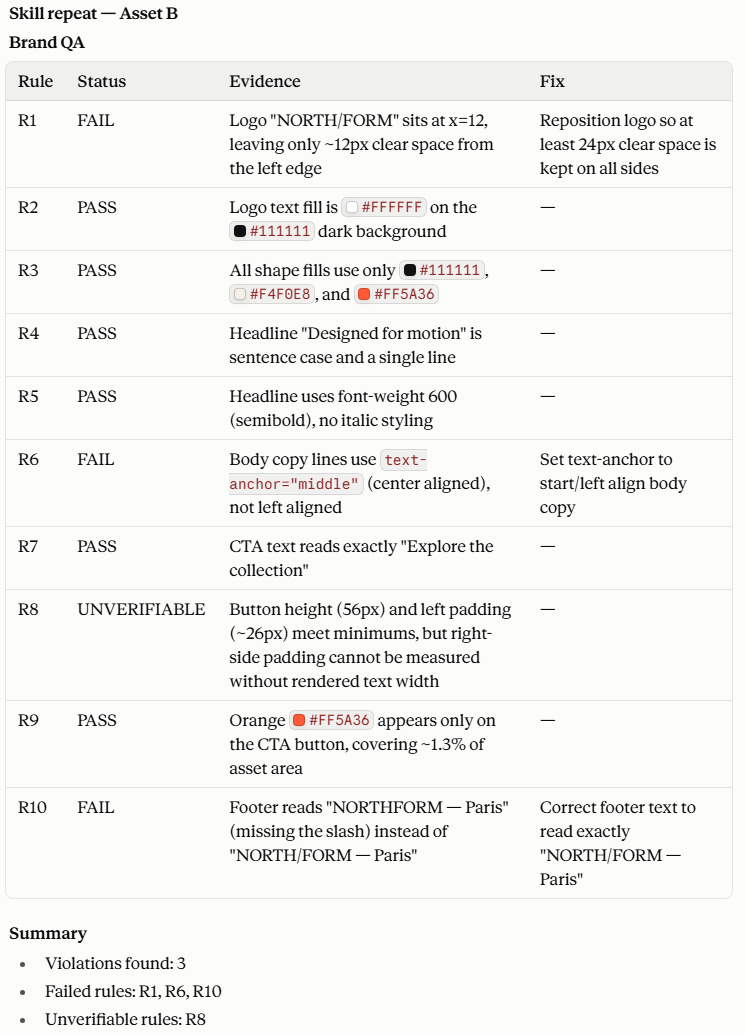 Skill — repeat
Ce que ça ne remplace pas
La direction artistique, la validation finale de marque, le jugement humain sur les nuances, les exceptions créatives et les décisions qui ne sont pas formalisées dans la Skill.
Verdict final — Répétitif : oui. Ponctuel : pas nécessaire.
La Skill simplifie surtout le fait de réutiliser toujours la même méthode. Dans notre test, elle a été légèrement plus fiable qu’un bon prompt, sans devenir plus intelligente ni parfaitement stable.
Deep dive — le test completSynthèse, planche des preuves visuelles, analyse détaillée et protocole, fiche complète et sources. Environ 9 minutes de lecture.
Synthèse
Une Skill Claude est une procédure réutilisable : vous y rangez vos règles, votre méthode et le format de réponse attendu, puis vous la réactivez quand la même tâche revient. Sur notre test de contrôle de marque, elle a évité une fausse alerte que le bon prompt avait produite, mais elle n’a trouvé aucune erreur supplémentaire. Sa vraie valeur apparaît donc surtout quand le même travail revient souvent.
Planche des preuves visuelles
Test pratique AI No Bullshit — Claude Skill NORTH/FORM Brand QA · 22 septembre 2026
Preuve 01 Baseline complète vs Skill
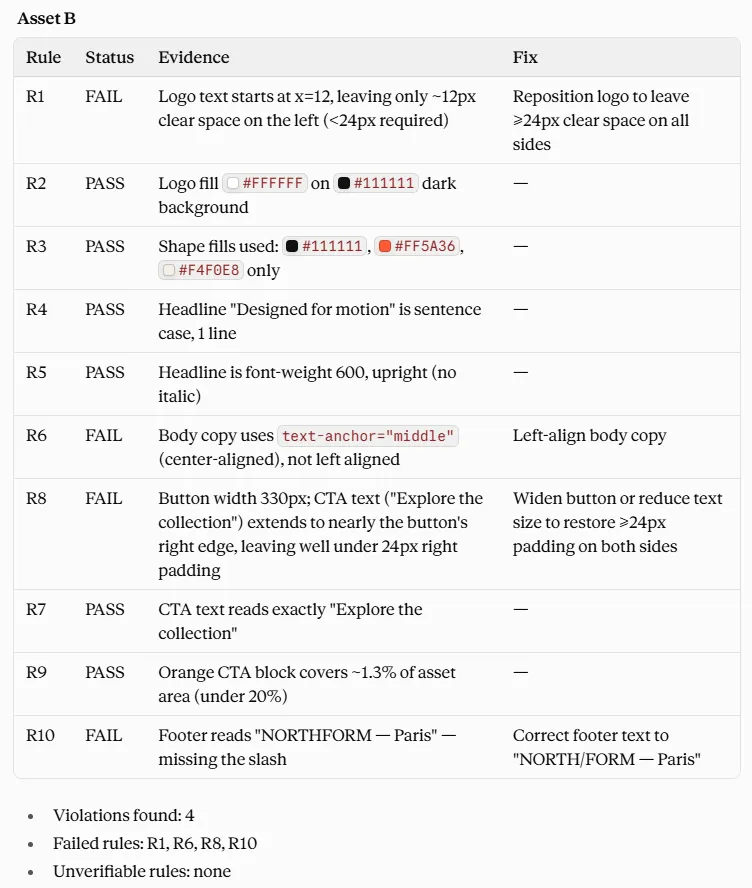
Baseline complète — Asset B
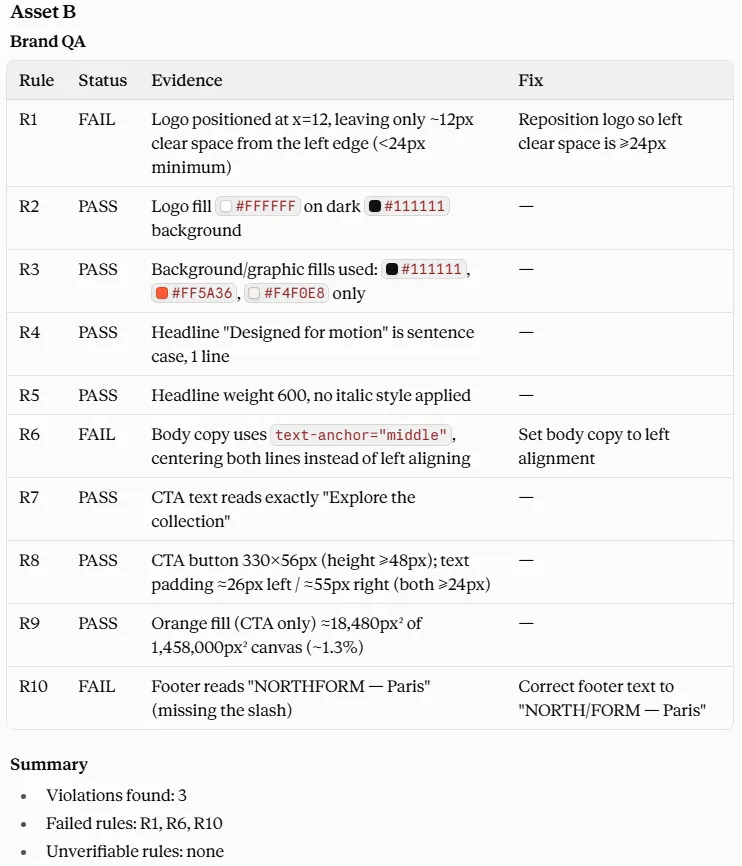
Skill — Asset B
Preuve 02 Repeat : pas parfaitement déterministe
Skill — run principal
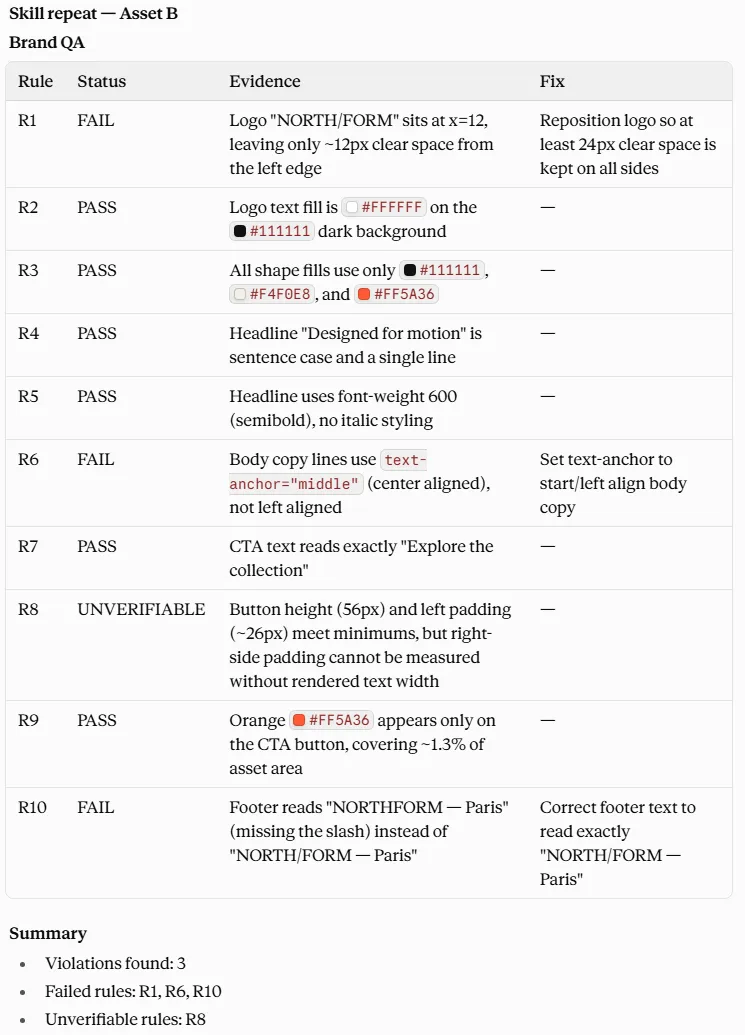
Skill — repeat
L'analyse complète
Une Skill, c’est quoi concrètement ?
Une Skill Claude, c’est une méthode que vous préparez une fois pour pouvoir la réutiliser.
Au lieu de redonner à Claude votre checklist, vos règles et la forme de réponse attendue à chaque nouveau chat, vous les rangez dans une Skill. Vous l’activez ensuite quand la même tâche revient.
Ce n’est donc pas un “Claude plus intelligent”.
C’est plutôt l’équivalent d’un mode opératoire enregistré.
Dans notre test, nous avons créé une Skill de Brand QA avec dix règles NORTH/FORM : logo, couleurs, titres, CTA, footer, etc. Ensuite, nous lui avons donné plusieurs assets à contrôler.
À quoi ça sert pour un créatif ?
Le cas testé est simple : vérifier toujours les mêmes règles de marque sur plusieurs créations.
Mais le principe peut s’appliquer à d’autres tâches répétitives, par exemple :
- contrôler toutes les déclinaisons d’une campagne avant livraison ;
- vérifier qu’une série de formats sociaux respecte toujours la même checklist ;
- appliquer le même process de review client à chaque nouvel asset.
Le point commun : la tâche revient souvent et les règles changent peu.
Si, à chaque fois, vous devez expliquer à Claude “vérifie le logo, puis les couleurs, puis le CTA, réponds dans ce format et n’invente pas d’autres règles”, la Skill commence à avoir du sens.
Ce que notre test dit vraiment
Nous avons comparé la Skill à un bon prompt accompagné exactement du même guide.
Les deux méthodes ont trouvé toutes les vraies erreurs de notre test.
La Skill a simplement évité une fausse alerte produite par le prompt.
Donc oui, elle a été un peu plus fiable sur ce cas.
Mais l’écart est faible.
Et lorsque nous avons relancé la Skill une seconde fois sur le même asset, un statut sur dix a changé. Elle reste donc dépendante du comportement du modèle : enregistrer la méthode ne transforme pas Claude en machine parfaitement déterministe.
Nous n’avons pas non plus démontré de gain de temps.
Transparence : notre comparaison principale comporte une réserve méthodologique : la baseline complète a dû être rejouée après ouverture du ground truth. Le protocole et les chiffres complets sont conservés dans le deep dive.
Quand ça vaut le coup
Vous faites souvent la même tâche + vous avez des règles claires = testez une Skill.
Le bénéfice principal n’est pas de rendre Claude beaucoup meilleur.
C’est d’éviter de reconstruire votre méthode à chaque fois.
Pour un studio ou un DA qui contrôle régulièrement des dizaines de déclinaisons, cela peut rendre le workflow plus propre et plus facile à partager.
Quand ça ne sert probablement à rien
Si vous avez juste une review à faire une fois, créer une Skill ajoute une étape inutile.
Notre bon prompt + guide était déjà presque aussi fiable.
Même chose si votre besoin est très ouvert — “est-ce que cette campagne est assez premium ?”, “quelle direction est la plus intéressante ?” — ou si vos règles changent à chaque projet.
Une Skill fonctionne mieux quand elle encode une procédure stable, pas quand elle doit remplacer le jugement créatif.
Comment l’activer et l’utiliser
Nous avons vérifié ce chemin sur Claude Free :
- Dans Settings → Capabilities, activer Code execution and file creation.
- Aller dans Personnaliser / Customize → Skills / Compétences.
- Ajouter ou uploader votre Skill, puis l’activer.
- Dans un nouveau chat, joindre vos assets et demander à Claude d’utiliser cette Skill pour la review.
Ensuite, le prompt peut devenir très court : la méthode est déjà dans la Skill.
La question expérimentale
Nous voulions isoler une variable :
à règles et modèle identiques, le fait d’encapsuler la méthode dans une Skill améliore-t-il la fiabilité et la répétabilité d’une review de marque ?
Le protocole imposait donc :
- même compte Claude Free ;
- même modèle Sonnet 5 ;
- chats frais ;
- hors Project ;
- Skill désactivée pour la baseline ;
- Skill activée pour la condition B ;
- mêmes quatre assets ;
- mêmes dix règles ;
- même ordre A → B → C → D ;
- aucun re-prompt pendant les runs principaux.
Le repeat sur Asset B servait uniquement à tester la stabilité, pas à modifier les scores principaux.
Les dix règles
La grille NORTH/FORM couvrait dix points volontairement vérifiables :
- logo et clear space ;
- couleur du logo ;
- palette ;
- casse et longueur du headline ;
- style du headline ;
- body copy ;
- texte exact du CTA ;
- géométrie du CTA ;
- usage de l’orange ;
- footer.
Aucune règle esthétique supplémentaire ne devait être inventée.
C’était essentiel : le test ne cherchait pas à savoir si Claude avait “du goût”, mais s’il appliquait correctement une grille explicite.
Le problème du premier run baseline
Le protocole gelé prévoyait un prompt baseline détaillé.
Le premier Run A a pourtant été lancé avec seulement :
“Review the four attached NORTH/FORM assets strictly against the attached mini brand guide.”
C’est une vraie déviation.
Ce résultat est donc conservé uniquement comme observation secondaire “prompt minimal + guide”.
Il ne sert pas au comparatif principal.
Pour rétablir la condition prévue, une baseline de remplacement a ensuite été exécutée avec le prompt complet gelé, sans interaction ni re-prompt.
Mais le ground truth avait déjà été ouvert
C’est la principale faiblesse méthodologique du dossier.
Même si le texte du prompt était figé avant l’unblinding et qu’aucune correction opportuniste n’a été injectée pendant le run, cette baseline a été exécutée après connaissance du ground truth par l’opérateur.
Nous conservons donc ses métriques parce qu’elles répondent beaucoup mieux à la condition expérimentale prévue que le premier prompt minimal.
Mais nous ne présentons pas ce comparatif comme un A/B aveugle parfait.
Le bon niveau de confiance est :
preuve pratique utile, pas benchmark scientifique.
Pourquoi le faux positif compte quand même
Sur un workflow de QA, le recall n’est pas le seul enjeu.
Rater une violation est grave.
Mais signaler à tort qu’un asset conforme est faux crée aussi du travail :
- vérification humaine ;
- correction inutile ;
- échanges avec un designer ;
- perte de confiance dans la checklist.
La Skill a supprimé ce faux positif sur notre run principal.
C’est donc un bénéfice réel.
Mais avec une seule différence sur quarante contrôles, il serait abusif de raconter une révolution de qualité.
Ce que la Skill change vraiment dans le workflow
Le changement le plus tangible n’est pas dans les métriques.
Il est dans le packaging.
Sans Skill, le workflow demande de fournir à chaque fois :
- le guide ;
- le prompt de contrôle ;
- le format de sortie ;
- les règles de traitement de l’incertitude.
Avec la Skill, tout cela devient une ressource activable.
Le prompt d’usage peut alors redevenir court :
“Using the active NORTH/FORM Brand QA Skill, review the four attached assets.”
Pour une équipe qui répète la même review, c’est la partie la plus crédible de la proposition.
La Skill fonctionne comme une procédure de QA empaquetée, pas comme un nouveau modèle.
Le chemin gratuit a été vérifié
Pendant la préparation, les sources officielles Anthropic consultées n’étaient pas parfaitement cohérentes : le Help Center indiquait que les Skills personnelles pouvaient être utilisées sur Free, tandis qu’une documentation plateforme et un ancien article réservaient encore l’upload custom aux plans payants.
Nous n’avons donc pas choisi la source qui nous arrangeait.
Nous avons créé un compte Claude Free distinct et testé le chemin.
Résultat :
- “Code execution and file creation” disponible ;
- bouton d’ajout de Skill présent ;
- upload d’une Skill custom réussi ;
- Skill visible et activable ;
- trace d’exécution montrant la lecture de son
SKILL.md; - réponse attendue obtenue.
L’upload et l’exécution d’une Custom Skill ont donc été vérifiés sur Claude Free le 22 septembre 2026.
Le Help Center Anthropic actuellement consultable indique désormais lui aussi les Skills sur Free, Pro, Max, Team et Enterprise.
Une friction avant même de commencer
La Skill de test n’a pas été totalement “upload and go”.
Le premier package généré avait un problème :
SKILL.mdsans YAML frontmatter ;- puis YAML dupliqué dans le body.
La structure a été corrigée avant toute condition scorée, sans modifier les dix règles du test.
Cela n’affecte donc pas le résultat comparatif.
Mais c’est un rappel utile pour le coût réel :
transformer une méthode en Skill demande un minimum de packaging et de QA de la Skill elle-même.
Et le temps ?
Des durées ont été notées pendant le test :
- premier Run A minimal : 1.43 min ;
- Run B Skill : 2 min ;
- repeat Skill : 38 s ;
- baseline de remplacement complète : 1.13 min.
Nous les conservons comme notes de protocole, pas comme preuve de productivité.
Deux raisons :
- le format de notation 1.43 / 1.13 n’a pas été confirmé comme minutes décimales ou min:s ;
- le temps de setup complet de la Skill n’a pas été chronométré.
Nous ne pouvons donc pas conclure que la Skill fait gagner ou perdre du temps.
Et sur ce run précis, rien ne justifie de raconter qu’elle est plus rapide.
Quand une Skill Brand QA devient intéressante
Une Skill Brand QA devient intéressante lorsque la tâche est :
- répétitive ;
- fondée sur des règles explicites ;
- exécutée sur de nombreux assets ;
- censée toujours produire le même format ;
- suffisamment stable pour mériter d’être standardisée.
Elle peut éviter de réécrire la procédure à chaque chat et rendre le workflow plus facile à transmettre.
C’est particulièrement pertinent pour :
- équipes design ;
- studios produisant beaucoup de déclinaisons ;
- contrôles de campagnes ;
- adaptations multiformats ;
- checklists de livraison.
La Skill ne sait que ce que vous avez formalisé
Elle ne remplace pas :
- une direction artistique ;
- un regard sur la pertinence créative ;
- une décision sur une exception de marque ;
- un arbitrage entre cohérence et idée forte ;
- la validation finale d’un asset sensible.
Si une règle n’existe pas dans la Skill, elle ne devrait pas être inventée.
Et si une règle est difficile à vérifier visuellement, la Skill ne transforme pas Claude en outil de mesure déterministe.
Ce qu’il faudrait tester ensuite
Le prochain test devrait sortir du dataset synthétique.
Nous voudrions vérifier la même Skill sur :
- une vraie série de déclinaisons de campagne ;
- davantage d’assets ;
- plusieurs sessions espacées ;
- plusieurs utilisateurs ;
- des règles visuelles ambiguës ;
- une évolution du brandbook nécessitant une mise à jour de la Skill.
Et mesurer cette fois :
- temps de setup ;
- temps moyen par review ;
- taux de faux positifs/faux négatifs sur un échantillon plus large ;
- stabilité d’un run à l’autre ;
- friction réelle de maintenance.
Si l’encapsulation réduit durablement les dérives et la charge opérationnelle, alors une recommandation sans réserve deviendra beaucoup plus défendable.
Sources et transparence
Test interne AI No Bullshit — 22 septembre 2026
Claude Free, Sonnet 5, quatre assets synthétiques NORTH/FORM, dix règles, quarante contrôles.
Anthropic Help Center — How to create custom skills
Documentation de création et de disponibilité des Custom Skills.
Anthropic Help Center — Use skills in Claude
Documentation d’activation, d’upload et d’usage des Skills selon les plans.
Éléments du protocole utiles à la preuve
- 4 assets synthétiques × 10 règles = 40 contrôles.
- Ground truth : 12 violations réelles, 28 contrôles conformes.
- Baseline complète scorée : TP12 / FP1 / FN0 / TN27.
- Skill scorée : TP12 / FP0 / FN0 / TN28.
- Gain observé : +7,7 points de précision, +4,0 points de F1, recall inchangé à 100 %.
- Repeat Skill sur Asset B : 9/10 statuts identiques.
- Les vraies violations R1 / R6 / R10 restent détectées au repeat.
- R8 passe de PASS à UNVERIFIABLE.
- Le premier Run A minimal est exclu du scoring principal car son prompt ne correspondait pas au protocole gelé.
- La baseline complète de remplacement a été exécutée après ouverture du ground truth : caveat méthodologique obligatoire.
- Aucun re-prompt ni correction interactive pendant les conditions scorées.
- Custom Skill upload + exécution vérifiés sur un compte Claude Free distinct.
- Packaging corrigé avant scoring : problème de YAML/frontmatter dans
SKILL.md, sans changement des dix règles. - Durées rapportées conservées telles quelles mais aucun gain de temps revendiqué.
La fiche complète
- Verdict public
- UTILE — ça vaut le coup ?ÇA DÉPEND
- Verdict (échelle interne)
- Verdict :TEST
- Niveau de preuve
- Testé par nous — Un test pratique a réellement été réalisé.
- Impact métier
- Moyen — Peut améliorer un cas réel, mais ne change pas la façon de travailler.
- Pour qui
- Designers, Directeurs artistiques, Créatifs
- Prix annoncé
- Les Custom Skills sont disponibles sur Claude Free, Pro, Max, Team et Enterprise selon le Help Center Anthropic actuel, avec l’exécution de code activée.
- Coût réel
- 0 € possible sur Claude Free. Le coût réel est surtout le temps de création, de packaging, de test et de tuning de la Skill, plus les limites d’usage du plan Claude. Notre test n’a pas mesuré ce coût de setup de bout en bout.
- Installation
- Activation vérifiée : Settings → Capabilities → Code execution, puis Customize → Skills → ajouter/activer. Temps de setup total non mesuré de bout en bout pendant ce test ; une friction de packaging SKILL.md/ZIP a dû être corrigée avant les conditions scorées.
- Apprentissage
- Faible pour une Skill text-only simple, mais il faut savoir formaliser les règles et construire un format de sortie non ambigu.
- Difficulté
- Facile
- Gain potentiel
- Intéressant surtout si vous répétez souvent la même tâche structurée : vous préparez la méthode une fois puis la réutilisez. Aucun gain de temps n’a été démontré dans notre test.
- Ce que ça améliore
- Tâches créatives répétitives avec règles fixes : Brand QA, contrôle de déclinaisons, checklists de livraison et autres reviews qui doivent toujours suivre la même méthode.
- Ce que ça ne remplace pas
- La direction artistique, la validation finale de marque, le jugement humain sur les nuances, les exceptions créatives et les décisions qui ne sont pas formalisées dans la Skill.
- Avantages
- La méthode, les règles et le format sont réutilisables sans tout réécrire à chaque chat.
- Dans notre test, la Skill a évité la seule fausse alerte produite par le bon prompt.
- Les vraies erreurs ont toutes été détectées dans les deux conditions.
- Upload et exécution d’une Custom Skill vérifiés sur un compte Claude Free.
- Limites
- Pour une tâche ponctuelle, le gain face à un bon prompt est trop faible pour justifier forcément une Skill.
- Une Skill ne rend pas Claude parfaitement stable : un statut a changé lors de notre repeat.
- Aucun gain de temps n’a été démontré.
- Notre comparaison principale comporte une réserve méthodologique détaillée dans le deep dive.
- Créer et empaqueter correctement la Skill demande un peu de préparation.
- Publié le
- Mis à jour le
- Dernière vérification
- À revérifier après le
D'où viennent nos informations
Notre travail — preuve interne
- Test pratique AI No Bullshit — Claude Skill NORTH/FORM Brand QA